
 @Esper967
dsh-music-insight
让你的dsh模型感受音乐
- Stars
- 1
- Language
- Python
- Created
- Oct 21, 2026
- Updated
- Oct 23, 2026
Introduction
dsh-music-insight
"让模型感受音乐"
把音频压成一句感受 + 三个情绪词 + 一行走向
不调用任何第三方接口。需要长报告时仍然有(--mode strict 的证据清单)
音频 ──▶ 测量层(确定性算法)
      ──▶ 感官层(vibe-v2:数字 → 一句感受 / 三个词 / 一行走向)
      ──▶ 证据层(JSON / PNG / Markdown,需要时才看)
      ──▶ 任意 LLM 说一句像刚听完的话
纯 CPU、零 API、离线可跑(可选依赖只用于解码与非 WAV 格式)。
默认输出长这样
# 听完《雨上がりの空》

> glassmoon · 2:59 · 112 BPM · C 大调

## 感觉

像雨停之后一个人走回家:先是空的,中间暖起来,最后散了。听完是松的。

很亮 / 偏慢 / 空

## 走向

0:00 起 → 0:26 涨 → 1:34 满 → 2:50 收

112 BPM · 亮 · 暖 · 空

## 数据

2:59 · 112.3 BPM · C 大调 · -20.8 dB · 2.4/s · 中频 68%

和弦:C 92.9s / F 26.6s / G 23.7s / Am 17.3s(C 大调 / A 小调 二选一)
两种模式
| 模式 | 给谁 | 输出 | 解读提示词 |
|---|---|---|---|
vibe(默认) | 想听感受的人、聊天、播客脚本 | 一句感受 + 三个词 + 一行走向 | LLM_PROMPT_FUN(2–4 句 / ≤100 字,带 1 处数据) |
strict | 要引用、要核对、要跑评估 | 证据清单,每条结论指回字段 | LLM_PROMPT |
同一份 measurements,两种排法。短的是措辞,不是数据。
vibe 模式要求模型像一个懂行的朋友:第一句说人话、说情绪,然后顺口带 1 处具体数据
(1:34 那段 / 最满 -20 dB / C 大调 / 一直绕着 C-F-G),最多 2 个数据点、1 个术语。
数据是给感受撑腰的,不是用来报参数的——所以插件会把「调性 / 高频和弦 / 关键时间点响度」
单独喂给模型,让它有东西可引用,又不会变成念报告。
现在能做什么(实测数字)
在 POP909(909 首中文流行)的合成钢琴音频上评估:
| 能力 | 水平 | 说明 |
|---|---|---|
| 时长 / BPM / 响度 / 明暗 / 结构 | ✅ 可用 | BPM 误差通常在 ±2% 内 |
| 和弦(根音 / 性质) | 🟡 73.8% / 73.0% | 用 librosa 拍点;真实录音更低 |
| 调性 | 🟡 关系大小调二选一 | 由和弦序列反推,歧义会明确标注 |
| 旋律 | 🔴 不可用(19.5%) | 复调遮蔽,见「已知限制」 |
| 感官层(感受 / 情绪词 / 走向) | 🟡 规则映射 | 阈值表可读、可改,不是学习出来的 |
以上是合成音频上的数字,真实录音会更差。完整评估过程与失败记录见 docs/EVAL.md。
它是什么 / 不是什么
| 是 | 不是 |
|---|---|
| 把音频变成可复现的测量数据 | 音乐理解模型 |
| 把测量值压成一句感受(感官层) | 情绪识别 / 扒谱工具 |
| 生成给 LLM 读的听感底稿和提示词 | 自动乐评 SaaS |
| 明确标注置信度与失效条件 | 音频 LLM(它根本听不到声音) |
快速开始
git clone https://github.com/Esper967/music-insight.git
cd music-insight
pip install -e ".[decode]"        # numpy + pillow,av 用于 mp3/m4a/flac
pip install -e ".[dev]"           # 跑测试

# 1. 生成两段无版权的测试音频
python examples/make_demo.py out/demo.wav           # 19 秒,平的
python examples/make_arc_demo.py out/arc_demo.wav   # 36 秒,有起—满—收

# 2. 一句感受(默认 vibe)
music-insight out/arc_demo.wav --out out/demo

# 3. 证据清单(可引用)
music-insight out/arc_demo.wav --out out/demo --mode strict

# 4. 加上节拍 / 和弦 / 由和弦反推调性
music-insight out/arc_demo.wav --out out/demo --chords

# 5. 批量分析一个文件夹
python examples/batch.py "某处/音乐文件夹" --out out/batch
输出:
out/demo/
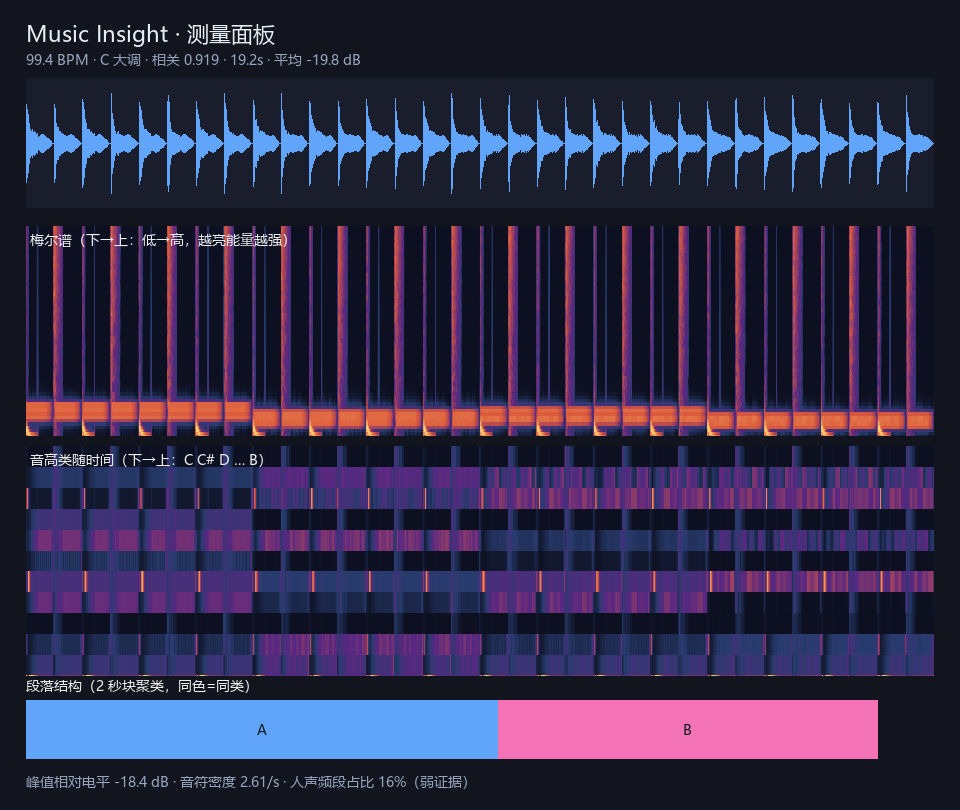
├── panel.png      # 波形 + 梅尔谱 + 音高类 + 结构条
├── analysis.json  # 测量值、结构、情绪先验、感官层、元信息
├── timeline.csv   # 8 秒粒度时间线
├── report.md      # 一句感受(vibe)或证据清单(strict)
└── LIMITS.md      # 失效条件——限制外置,不挡正文
设计原则:短的是措辞,不是数据
- 测量层只放确定性算法,每个数字都能复现、能被基准检验。
- 感官层(
vibe.py)只做一件事:把测量值按阈值表压成一句话。 v2 刻意删掉了骨架表、手感表、听感锚点——那些信息留在analysis.json里给机器看。 它不新增音频计算,也不判断乐器 / 人声 / 流派。 - strict 模式保留完整的证据索引,供核对。
- 限制外置成
LIMITS.md:限制不会消失,但不该让模型一打开正文就先读到免责声明。 - 全程离线:没有网络层、没有评论抓取、没有性格预设。 「听完什么感觉」这件事,只由这首歌的测量值和一行提示词决定。
- 标题不可信:歌名 / 歌手 / 专辑只是文件标签,可能是错的、被改过的、同名不同曲。 模型在输出前会被告知:不要搜索、不要引用任何网络信息,只按测量转化出的感受说话。
为什么不直接让模型自己翻译数字?因为它每次翻的都不一样,而且容易翻错。 把翻译固化在代码里,措辞就可以被 review、被 git diff、被你说「这句太文艺了,改掉」。
已知限制
- 旋律提取不可用:完整混音上 RPA 19.5%,单独旋律轨 68–77%——瓶颈是复调遮蔽。
- 和弦性质依赖语料先验:
QUALITY_PRIORS来自中文流行,换到古典/爵士会偏。 - 调性只能到关系大小调层级:两者共享全部调内和弦,报告会并列两个候选。
- 节拍跟踪较弱:自研 F-measure 0.21,librosa 0.34;对和弦聚合影响 5–6 个点。
- 感官层的措辞是规则,不是理解:阈值表决定它说你「亮」还是「暗」, 改表就能改性格;它不会因为这首歌真的悲伤就说什么。
- 无流派 / 年代 / 乐器识别:需要另外的嵌入模型。
- 完整失效条件见每次运行生成的
LIMITS.md(源码里的report.LIMITS_MD)。
作为 DeepSeek Harness 插件使用
dsh-plugin/ 是一个符合 DSH 的 Host 插件 bundle,注册一个 music_insight 工具:
给一条音频路径,返回一句感受 + 三个情绪词 + 一行走向与文件路径。全程本地离线。
dsh plugin --profile <你的 profile 名> add <本仓库路径>/dsh-plugin
也可以让 agent 调用 plugin_manager 的 install_bundle,target 填 dsh-plugin 的绝对路径。
配置在 dsh-plugin/cordis.patch.yml:
| 键 | 作用 |
|---|---|
pythonPath | 装了 numpy + pillow(mp3 还需 av)的 Python;留空用 PATH 上的 python |
repoRoot | music-insight 仓库路径;插件在仓库内时自动推导 |
defaultChords | 是否默认跑节拍/和弦(默认 true) |
defaultMode | 默认报告模式:vibe(默认)或 strict |
工具参数:
| 参数 | 说明 |
|---|---|
file_path | 必需。音频路径,相对路径按会话工作目录解析 |
mode | vibe(默认)/ strict,覆盖配置默认值 |
chords | 是否跑节拍/和弦,覆盖配置默认值 |
output_dir | 可选。输出目录,默认 <歌名>-分析/(放在音频同目录) |
工具描述本身就是给模型的指令:要求「2–4 句、≤100 字、先说感觉、情绪直接说、不总结不排比」, 所以模型拿到结果后不会再甩一张频谱表。
已验证:WAV(标准库解码)与 MP3(PyAV,含 ID3 标签)都能跑通。
改完插件里的措辞后,不用重启 DSH 就能预览模型会读到什么:
node dsh-plugin/preview-summary.mjs out/demo/analysis.json vibe
测试
pip install -e ".[dev]"
pytest -q      # 31 个测试,不需要下载数据集,也不联网
Roadmap
- 旋律提取(dominant melody extraction,例如 Basic Pitch)——当前最大空白
- 和弦继续提升:更多和弦类型、更大评测集、真实录音验证
- 调性定到绝对调名(需要旋律或终止式信息)
- CLAP / MERT 嵌入 → 流派与情绪标签(有监督、可评估)
- 可选音频 LLM 后端:真的把声音给模型听,而不是只看测量(唯一能拿到音色的路)
Prior art
- MOSS-Music-Data-Pipeline — 训练语料标注管线
- review-music — MIR → 结构化评论,思路最接近
- Musia — 本地音乐工具链封装
- LTU / Music Flamingo — 训练音频编码器的路线,需要 GPU 与数据
差异点:测量与措辞分层(数字可核对、措辞可 review)、零 API 纯本地、全程离线。 「听完什么感觉」只由这首歌本身决定,不掺别人的评论、不套性格预设。
许可
MIT