
 @xmdxzy
dsh-gpu-governor
GPU governor plugin for DSH: per-process VRAM attribution grouped into projects, a top-5 board with budgets, and guarded suspend/resume/kill control
- Stars
- 1
- Language
- JavaScript
- Created
- Oct 26, 2026
- Updated
- Oct 26, 2026
Introduction
GPU Governor
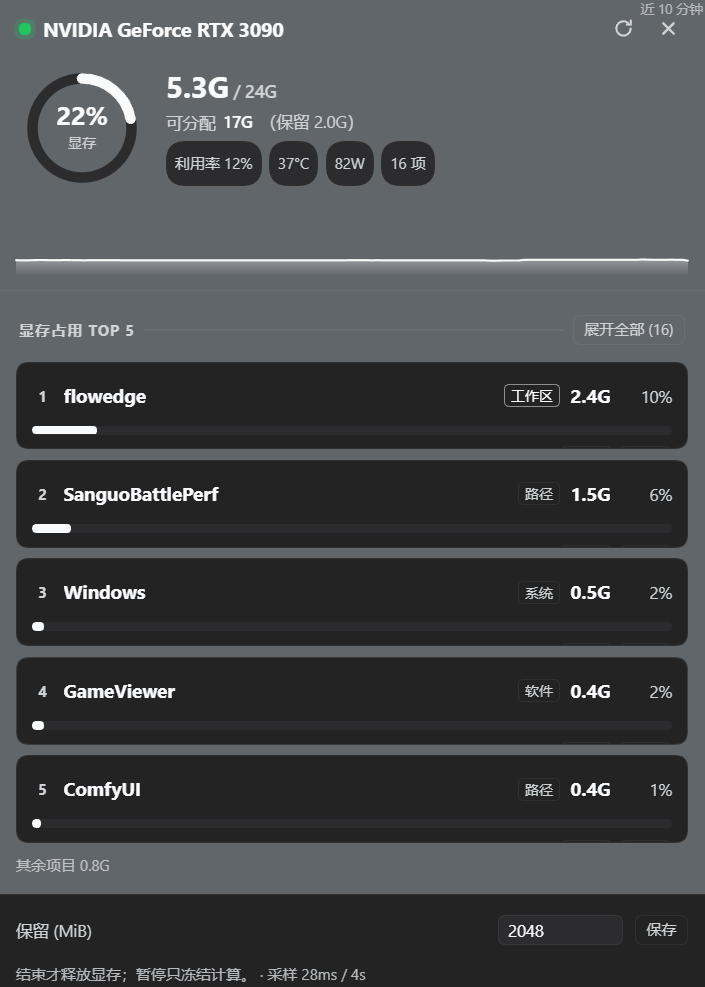
AI 任务一多,显存就成了公共资源。ComfyUI、推理服务、游戏、还有几个忘了关的旧进程一起分,谁也说不清自己还剩多少。Windows 自带的工具不告诉你谁在占,nvidia-smi 在 WDDM 驱动下那张表的 per-process 显存一列永远显示 [N/A],只剩一个总数。想知道「刚才那 20G 是谁吃掉的」,只能自己去翻驱动暴露的性能计数器。
这个插件在 DSH 输入框左边挂一个小徽标,点开就是上面这块浮层:谁在吃显存、吃了多少、还能不能再开一个任务、要不要让某个项目先让一让。
不点开的时候它就是个 ● GPU 38% 17.3G/24.0G 的细条,圆点按占用分三档变色(品牌色、黄、红并缓慢呼吸)。
面板上每一块是什么
居中的大圆环是整卡显存占用率,旁边 5.3G / 24G 是绝对量。
底下那行 可分配 17G(保留 2.0G) 比百分比实用得多。它不是「剩余 18.7G」,而是先扣掉你设定的保留区。跑训练的都清楚,显存被别的进程临时啃一口,整个任务就 OOM 了,留一块缓冲比卡着满额分配稳。
四个小胶囊依次是利用率、温度、功率、当前进程数。这几个数只帮你判断卡是闲着还是被压满,不参与排名。
再往下是最近十分钟的显存曲线。宿主进程活着时由它保留;宿主重启过的话面板会从当下重新累积,所以刚打开那阵子可能是空的。
然后是这块面板的核心,显存占用 TOP 5。
每一项是一个项目,不是 PID。这点很关键。你同时开着五个 python.exe,按 PID 列出来根本对不上号;按项目聚合之后,是 ComfyUI 还是 SanguoBattlePerf 一眼就能认出来。
每行右侧那个小标签说明名字是怎么来的:
工作区:落在某个 DSH 工作区里路径:从命令行里的脚本路径推出来的软件:装在Program Files或AppData\Local\Programs下的应用系统:Windows 系统目录
再往右是占用的显存和占整卡的百分比。进度条按整卡宽度画,所以「它吃了半张卡」不用心算,扫一眼就有数。
点开一行,展开的是这个项目下的所有进程:PID、各自显存、完整命令行(鼠标悬浮显示)。行内的控制按钮作用在整个项目上,成员逐个执行。
展开全部 (16) 放出前 5 名之外的其余项目。截图里剩下那 11 个加起来才 0.8G,平时不用管,偶尔能揪出某个忘了关的东西。
底部 保留 (MiB) 就是前面说的保留区,默认 2048,改完点保存写进 state.json,重启后仍然生效。
最底下那行小字,「结束才释放显存;暂停只冻结计算」,是这插件最容易被误解的地方,下面单独讲。
三个动作的区别
这个必须先说清楚,不然容易误操作。
| 动作 | 显存 | 计算 | 底层实现 |
|---|---|---|---|
| 暂停 | 不释放,仍然占着 | 冻结,把 SM 时间让出来 | NtSuspendProcess |
| 恢复 | 不变 | 解冻,继续跑 | NtResumeProcess |
| 结束 | 真正释放 | 进程终止 | taskkill /F /T,连子进程一起 |
也就是说**「暂停」腾不出显存**,它只是把那个进程钉住,不再抢算力。想让显存回来,只有结束这一条路。
结束要连点两次,第一次按钮会变成「确认终止」,四秒内有效。防的就是手滑把跑了半天的训练任务杀掉。
暂停和恢复用的是 NT 原生 API,不是 PowerShell 那套 Suspend-Job,后者管不到别人的进程。
几个硬性闸门写在 act 里,不指望界面自觉:
- 只能操作当前快照里出现过的 GPU 进程,页面开久了也点不到别的东西
- PID 小于等于 8 的一律拒绝
- Harness 自己的进程和它的父进程也拒绝
- 每个动作无论成败都往
audit.jsonl追一行,超过 512KB 轮转
暂停和结束他人进程需要 DSH 以管理员身份运行。权限不够时会显示 access denied: run DSH elevated,不会静默失败。
实测过(不是推断):在受控探针里起一个占 183 MiB 的 CUDA 进程并持续写心跳文件,对项目执行 suspend,心跳冻结在 39 字节整整 2.2 秒不动;resume 之后继续长到 48 字节。
项目名是怎么猜出来的
一条命令行里能提取路径的地方有好几处,证据强弱不一样,所以先分三桶,再按顺序套规则。
最硬的是 script 桶,命令行里正在执行的那个脚本或工程文件,比如 D:\AI\ComfyUI\main.py、SanguoBattlePerf.uproject。这是「此刻真正在跑的东西」。
其次 binary 桶,解释器或可执行文件本身,比如 ...\Python311\python.exe。它只能说明用了什么软件,说明不了在跑哪个项目。
最弱的是 arg 桶,参数里带的目录,比如 --user-data-dir=...\Roaming\@deepseek-ai。
然后按这个顺序匹配,谁先命中算谁:
- 落在某个 DSH 工作区里,标
工作区 ...\Desktop\<项目>,标桌面AI/Projects/UEProjects/models/code/work/src这类具名容器下的子目录AppData\Local\Programs\<应用>或Program Files\<厂商>\<产品>- 盘符首级目录,比如
D:\<项目> - 可执行文件所在目录名
C:\Windows这类系统树
几个实际例子:
python.exe D:\AI\ComfyUI-H3\main.py→ ComfyUI-H3,不是「Python」UnrealEditor-Cmd.exe D:\UEProjects\...\SanguoBattlePerf.uproject→ SanguoBattlePerfDeepSeek Harness.exe --user-data-dir=...\Roaming\@deepseek-ai\dsh-desktop→ DeepSeek Harness,不是「@deepseek-ai」
同一条命令行里有多条路径时会按上面的顺序竞争,第一个命中的决定名字。
数据从哪来,为什么这么快
Windows WDDM 下 nvidia-smi 拿不到每进程显存,只能退到驱动暴露的 WMI 性能计数器:
- 每进程显存:
Win32_PerfFormattedData_GPUPerformanceCounters_GPUProcessMemory的DedicatedUsage - 每进程 GPU 利用率:
Win32_PerfFormattedData_GPUPerformanceCounters_GPUEngine的UtilizationPercentage - 整卡显存、温度、功率:
nvidia-smi --query-gpu=...
三条路都在同一台机器、同一时刻实测过:
| 方案 | 单次采样耗时 | 结论 |
|---|---|---|
Get-Counter | 6–14 秒 | 每轮重新枚举实例并阻塞采样,太慢,放弃 |
typeperf | 1.6–3.4 秒 | 每次起进程再加一秒费率窗口,放弃 |
| WMI 性能类 | 显存 25ms / 引擎 330ms | 采用 |
所以采集器做成一个常驻的 PowerShell 子进程(lib/collector.ps1),每轮吐一行 JSON,父进程挂掉它自己退出。引擎类指标每个周期只刷一次,它对延迟不敏感;进程名表缓存 15 轮,遇到新 PID 单独补查。默认四秒一轮,实测每轮 140–750ms。截图底部那个 采样 28ms / 4s 就是当轮的真实耗时。
装到 DSH 上
插件按普通 profile 行的方式挂载,改配置热加载,不随客户端升级丢失。
在 ~/.dsh/profiles/desktop/cordis.patch.yml 里加这一块:
- insert:
    - id: gpu-governor
      name: "file:///C:/Users/<you>/.dsh/plugins/dsh-gpu-governor/lib/index.js"
      config:
        intervalMs: 4000
路径换成插件实际所在位置。想卸载就把这块删掉。
热加载有边界,这几条是实测出来的:
- 改
lib/client.js(浏览器那一半),刷新页面就生效 - 改
lib/index.js或两个.ps1(宿主那一半),必须重启桌面客户端;只改 patch 只会重载浏览器半,宿主插件不会重新 apply - 本 profile 上
plugin_manager重启不了这个条目,会抛dsh-tui: root.events.emit is unavailable from a plugin activation,那是别的插件卸载期留下的报错
嫌手动重启麻烦,仓库里有个 restart-dsh.ps1:停客户端、清掉遗留的采集器、重启、等新 host 进程出现并列出它监听的端口,最后把采集器实例数写进 restart-check.log。先加 -DryRun 可以只看它打算动什么,不真动。
运行时文件落在:
~/.dsh/gpu-governor/state.json:预算和保留余量~/.dsh/gpu-governor/audit.jsonl:每个管控动作一行
边界
- 只按显存排名,利用率仅作参考列。这是故意的,显存才是 OOM 的元凶。
- 「峰值」是宿主进程这一轮生命周期内的高水位,不是历史数据库,重启归零。
- 趋势窗口是宿主保留的最近 200 个采样(四秒一轮大约 13 分钟),前端再抽稀到 120 点绘制。
- 只展示
gpu[0]。多卡机器上其余卡的数据采得到,但面板没画。 - 同一个 exe 的多个实例,如果命令行里没有路径差异,会被合并成一个项目。这是预期行为。
- 采集器第一次启动要 0.9–10 秒才出第一行(WMI 类首次加载),这段时间面板显示骨架屏。
- 两次快照之间退出的进程,那一行会变成禁用的
alive: false。 - 项目级动作逐个成员串行执行,成员多的时候要占几百毫秒,因为每个成员都要起一次 PowerShell 进程。
- 预算是软配额,只做提示和可视化,不拦进程启动,也不自动杀进程。自动杀掉一个跑了六小时的训练,代价远大于省下来的那点显存。